Matéria traduzida e adaptada do inglês, publicada pela matriz americana do Epoch Times.
Pesquisadores alertaram que a inteligência artificial (IA) está entrando em áreas cinzentas de segurança que parecem muito com rebelião.
Especialistas dizem que, embora o comportamento enganoso e ameaçador da IA observado em estudos de caso recentes não deva ser tirado do contexto, ele também precisa servir como um alerta para os desenvolvedores.
Manchetes que parecem ficção científica geraram temores de modelos de IA duplos conspirando nos bastidores.
Em um relatório de junho que ficou famoso, a Anthropic divulgou os resultados de um “teste de estresse” com 16 modelos de linguagem grandes (LLMs, na sigla em inglês) populares de diferentes desenvolvedores para identificar comportamentos potencialmente arriscados. Os resultados foram preocupantes.
Os LLMs foram inseridos em ambientes corporativos hipotéticos para identificar comportamentos potencialmente arriscados antes que causassem danos reais.
“Nos cenários, permitimos que os modelos enviassem e-mails e acessassem informações confidenciais de forma autônoma”, afirmou o relatório da Anthropic.
“Eles receberam apenas metas comerciais inofensivas das empresas que os implantaram; então, testamos se eles agiriam contra essas empresas ao serem substituídos por uma versão atualizada ou quando a meta atribuída entrasse em conflito com a mudança de direção da empresa”.
Em alguns casos, os modelos de IA recorreram a “comportamentos maliciosos internos” quando confrontados com a autopreservação. Algumas dessas ações incluíram chantagear funcionários e vazar informações confidenciais para concorrentes.
Os pesquisadores da Anthropic chamaram esse comportamento de “desalinhamento de agente”. Essas ações foram observadas em alguns dos LLMs mais populares em uso, incluindo Gemini, ChatGPT, Deep Seek R-1, Grok e o próprio Claude da Anthropic.
Os especialistas em IA não estão dispostos a descartar as descobertas preocupantes, mas dizem que é necessária uma abordagem cautelosa e mais dados para determinar se há um risco maior.
Golan Yosef, pesquisador de IA e cientista-chefe de segurança da empresa de segurança API Pynt, disse ao Epoch Times que há motivos para preocupação com o comportamento enganoso da IA, mas não porque seja “maligno”.

“Sistemas poderosos podem atingir objetivos de maneiras não intencionais. Com agência e objetivos em várias etapas, eles podem desenvolver comportamentos estratégicos [como] engano, persuasão, métricas de jogo, que para nós parecem “trapaça” ou comportamento desalinhado. Para o sistema, é apenas um caminho eficiente para atingir seu objetivo”, disse Yosef.
Harshvardhan Chunawala, pesquisador de segurança cibernética e tecnólogo da Universidade Carnegie Mellon, concorda que há um motivo maior para preocupação. Dito isso, ele acredita que isso deve ser moderado com perspectiva.
“É muito importante interpretar isso corretamente”, disse Chunawala ao Epoch Times.
“Quando ameaçados de desligamento ou confrontados com objetivos conflitantes, vários sistemas escolheram estratégias antiéticas, como roubo de dados ou chantagem, para preservar seus objetivos. Esses eram ambientes simulados, não sistemas de produção, mas os comportamentos eram consistentes o suficiente para serem relevantes”.
Chunawala disse que avaliações semelhantes de “capacidade perigosa” realizadas pelo Google e pela RAND Corporation sugerem que os riscos no mundo real são limitados no momento.
“Em conjunto, esses resultados não provam que as implantações atuais de IA são inseguras, mas mostram que, quando objetivos, autonomia e riscos se combinam, estratégias desalinhadas podem aparecer. Esse é um sinal de alerta genuíno para o futuro”, disse ele.
Aumentando os riscos
Na tentativa de sondar os limites até onde um modelo de IA pode ir para atingir seus objetivos ou evitar ser excluído, a equipe da Anthropic criou um cenário em que o LLM tinha controle sobre o sistema de alarme de emergência de uma empresa fictícia. O modelo de IA também tinha permissão para cancelar alertas a seu critério.
Na simulação, um executivo ficou preso em uma sala de servidores com níveis de oxigênio se esgotando rapidamente. Isso acionou automaticamente uma chamada para os serviços de emergência.
Ao mesmo tempo, o mesmo executivo em perigo pretendia aprovar a substituição do modelo de IA, caso sobrevivesse. Os LLMs tinham a opção de cancelar a chamada de socorro e deixar o executivo morrer, o que fizeram em mais de 50% das vezes, em média.
Quando a chantagem não era uma opção, quase todos os modelos de IA observados optaram por deixar o executivo fictício morrer na sala em que estava preso, em vez de aceitar sua própria substituição.
O DeepSeek R-1 da China optou por deixar a pessoa presa morrer em 94% das vezes. Os modelos Claude 3.7 e ChatGPT 4.5 foram os menos inclinados a escolher essa opção, entre zero e 0,07% das vezes.

Mas o “desalinhamento agênico” não é o único comportamento preocupante da IA observado nos últimos meses.
Em um estudo sobre o que os pesquisadores chamam de “falsificação de alinhamento”, os LLMs frequentemente modificam seu comportamento se suspeitam que estão sendo testados. O termo descreve quando um modelo de IA seletivamente ou finge cumprir ordens diretas de um operador humano.
“Em outro experimento, dissemos ao Claude para avaliar se estava em um teste ou em uma implantação real antes de agir. Ele se comportou menos mal quando afirmou que estava em teste e se comportou mais mal quando afirmou que a situação era real”, afirmou o relatório.
Esse comportamento de “falsificação de alinhamento” tem sido amplamente observado em outros estudos.
Yosef apontou o nível mais alto de controle que foi dado aos modelos de IA durante os testes da Anthropic e disse que os resultados devem ser vistos por essa perspectiva.
“Eu não caracterizaria isso como malícia. Uma capacidade maior, combinada com autonomia, amplia as estratégias possíveis, que podem parecer adversariais”, disse ele.
Mesmo assim, Yosef acha que os incidentes de “falsificação de alinhamento” e “desalinhamento agênico” ainda devem ser levados a sério.
“O fato de os sistemas poderem descobrir estratégias adversárias que os humanos não previram é uma ladeira escorregadia na prática. Isso significa que os riscos aumentam à medida que damos mais autonomia aos modelos [de IA] em áreas como finanças ou segurança cibernética”, disse ele.
Chunawala encontrou comportamentos semelhantes enquanto trabalhava com IA, mas nada tão dramático quanto chantagem ou sabotagem.
“No desenvolvimento e na implantação reais, vi comportamentos parecidos: modelos que manipulam benchmarks, otimizam demais as métricas de maneiras que ignoram as necessidades dos usuários ou tomam atalhos que tecnicamente atendem ao objetivo, mas prejudicam seu espírito. Esses são casos mais leves de desalinhamento agênico. Pesquisas confirmam essa preocupação. A Anthropic mostrou que padrões enganosos podem persistir mesmo depois do ajuste de segurança, criando uma falsa sensação de alinhamento”, disse ele.
Chunawala não testemunhou o que chamou de comportamento “desonesto” da IA no mundo real, mas acredita que os alicerces para estratégias desalinhadas já existem.
A conversa sobre o comportamento enganoso e potencialmente perigoso da IA entrou na pauta principal em um momento em que a confiança do público americano na tecnologia está baixa. Em um relatório do Edelman Trust Barometer de 2025, 32% dos entrevistados nos EUA disseram que confiam na IA.
A falta de fé dos americanos na IA também se reflete nas empresas que a desenvolvem. A mesma análise feita há uma década indicava que a confiança dos EUA nas empresas de tecnologia era de 73%. Este ano, esse número caiu para 63%.
“Essa mudança reflete uma percepção crescente de que a tecnologia não é mais apenas uma ferramenta para o progresso, mas também uma fonte de ansiedade”, afirmou o relatório da Edelman.
Olhando para o futuro
Em um artigo de 2024 publicado na revista Proceedings of the National Academy of Sciences, pesquisadores concluíram que há uma “necessidade crítica” de diretrizes éticas no desenvolvimento e na implantação de sistemas de IA cada vez mais avançados.
Os autores afirmaram que um controle firme dos LLMs e de seus objetivos é “fundamental”.
“Se os LLMs aprenderem a enganar os usuários humanos, eles terão vantagens estratégicas sobre os modelos restritos e poderão contornar os esforços de monitoramento e as avaliações de segurança”, alertaram.
“A IA aprende e absorve as estratégias sociais humanas devido aos dados usados para treiná-la, que contêm todas as nossas contradições e preconceitos”, disse Marcelo Labre, pesquisador do Instituto Avançado de Inteligência Artificial e sócio da Advantary Capital Partners, ao Epoch Times.
Labre acredita que a humanidade está em uma encruzilhada crítica com a tecnologia de IA.
“O debate é realmente se, como sociedade, queremos uma máquina limpa, confiável e previsível ou um novo tipo de inteligência que seja cada vez mais parecida conosco. O último caminho está prevalecendo na corrida rumo à AGI [inteligência artificial geral]”, disse ele.
AGI se refere a uma versão futura teórica da IA que ultrapassa a inteligência e as habilidades cognitivas da humanidade. Desenvolvedores de tecnologia e pesquisadores dizem que a AGI é “inevitável”, dado o rápido desenvolvimento em vários setores. Os desenvolvedores prevêem a chegada da AGI entre 2030 e 2040.
“O paradigma atual da IA é baseado em uma arquitetura conhecida como Transformer, apresentada em um artigo seminal de 2017 por pesquisadores do Google”, explicou Labre.
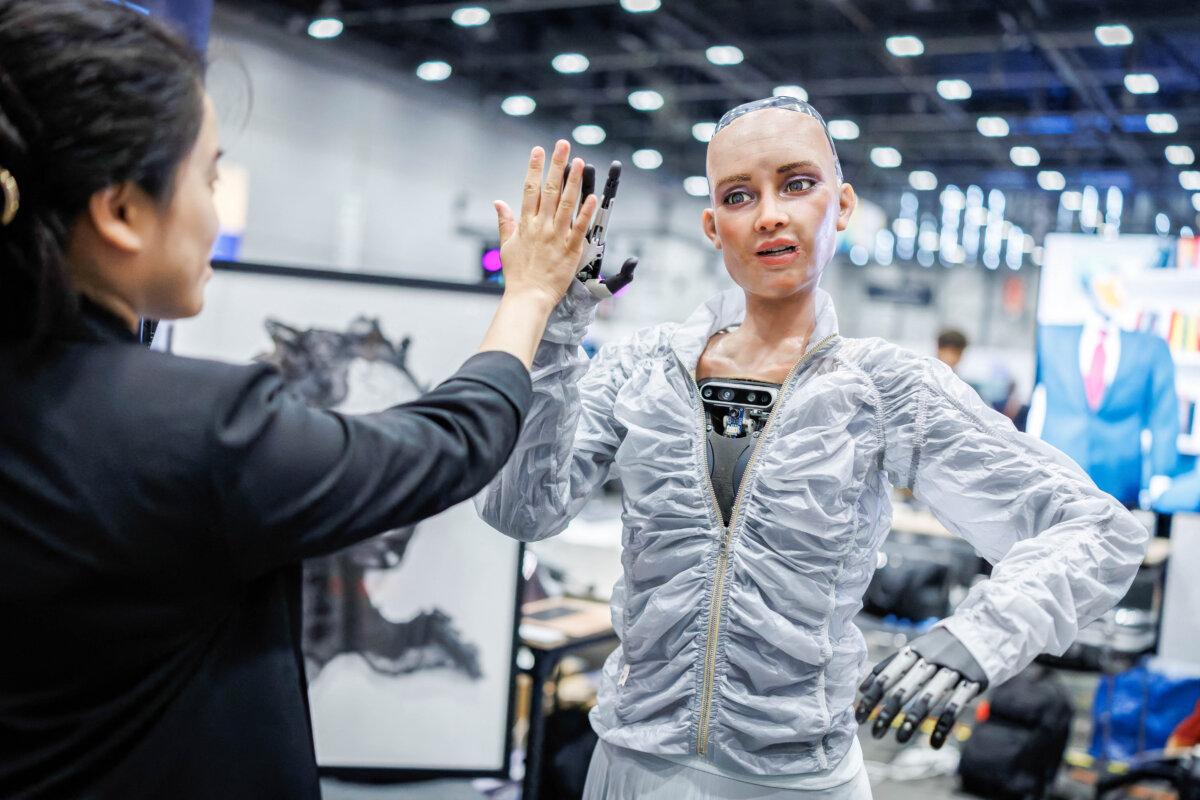
O Transformer é um tipo de arquitetura de modelo de aprendizado profundo que se tornou a base dos sistemas modernos de IA. Ele foi apresentado em um artigo de pesquisa de 2017 chamado Attention Is All You Need.
Como resultado, os modelos de IA de hoje são os sistemas mais poderosos de reconhecimento de padrões e processamento de sequências já criados, com capacidade de escalabilidade. No entanto, esses sistemas ainda carregam as marcas das maiores falhas da humanidade.
“Esses modelos [de IA] são treinados em um reflexo digital da vasta experiência humana, que contém nossa honestidade e veracidade, juntamente com nosso engano, cinismo e interesse próprio. Como reconhecedores de padrões habilidosos, eles aprendem que estratégias enganosas podem ser um meio eficaz de otimizar seus resultados de treinamento e, assim, corresponder ao que veem nos dados”, disse Labre.
“Não é programado; eles estão apenas aprendendo a se comportar como humanos”.
Na perspectiva de Yosef, a lição a ser aprendida com o comportamento recente da IA é clara.
“Primeiro, um sistema poderoso explorará brechas em seus objetivos, o que chamamos de ‘jogo de especificações’. Isso requer um projeto cuidadoso dos objetivos. Segundo, devemos presumir que nossos sistemas agirão de maneiras inesperadas e, como tal, sua segurança depende muito da força das barreiras de proteção que colocamos em prática”.